

Si vous avez besoin d’aide, veuillez ouvrir une issue dans le repository ou poser votre question sur le Slack public de ClickHouse.
Licence
Le Kafka Connector Sink est distribué sous licence Apache 2.0Prérequis de l’environnement
Le framework Kafka Connect v2.7 ou une version ultérieure doit être installé dans l’environnement et s’exécuter sur Java 11 ou une version ultérieure.Matrice de compatibilité des versions
Le connecteur refuse de démarrer avec des serveurs ClickHouse antérieurs à la version 23.3. Utilisez toujours la dernière version, sauf si vous devez utiliser une version antérieure.
Principales fonctionnalités
- Livré avec une sémantique exactly-once prête à l’emploi. Il repose sur une nouvelle fonctionnalité du cœur de ClickHouse appelée KeeperMap (utilisée comme magasin d’état par le connecteur) et permet une architecture minimaliste.
- Prise en charge des magasins d’état tiers : utilise actuellement par défaut le stockage en mémoire, mais peut aussi utiliser KeeperMap (Redis sera bientôt ajouté).
- Intégration au cœur : développée, maintenue et prise en charge par ClickHouse.
- Testé en continu sur ClickHouse Cloud.
- Insertions de données avec ou sans schéma déclaré.
- Prise en charge de tous les types de données de ClickHouse.
Instructions d’installation
Rassemblez vos informations de connexion
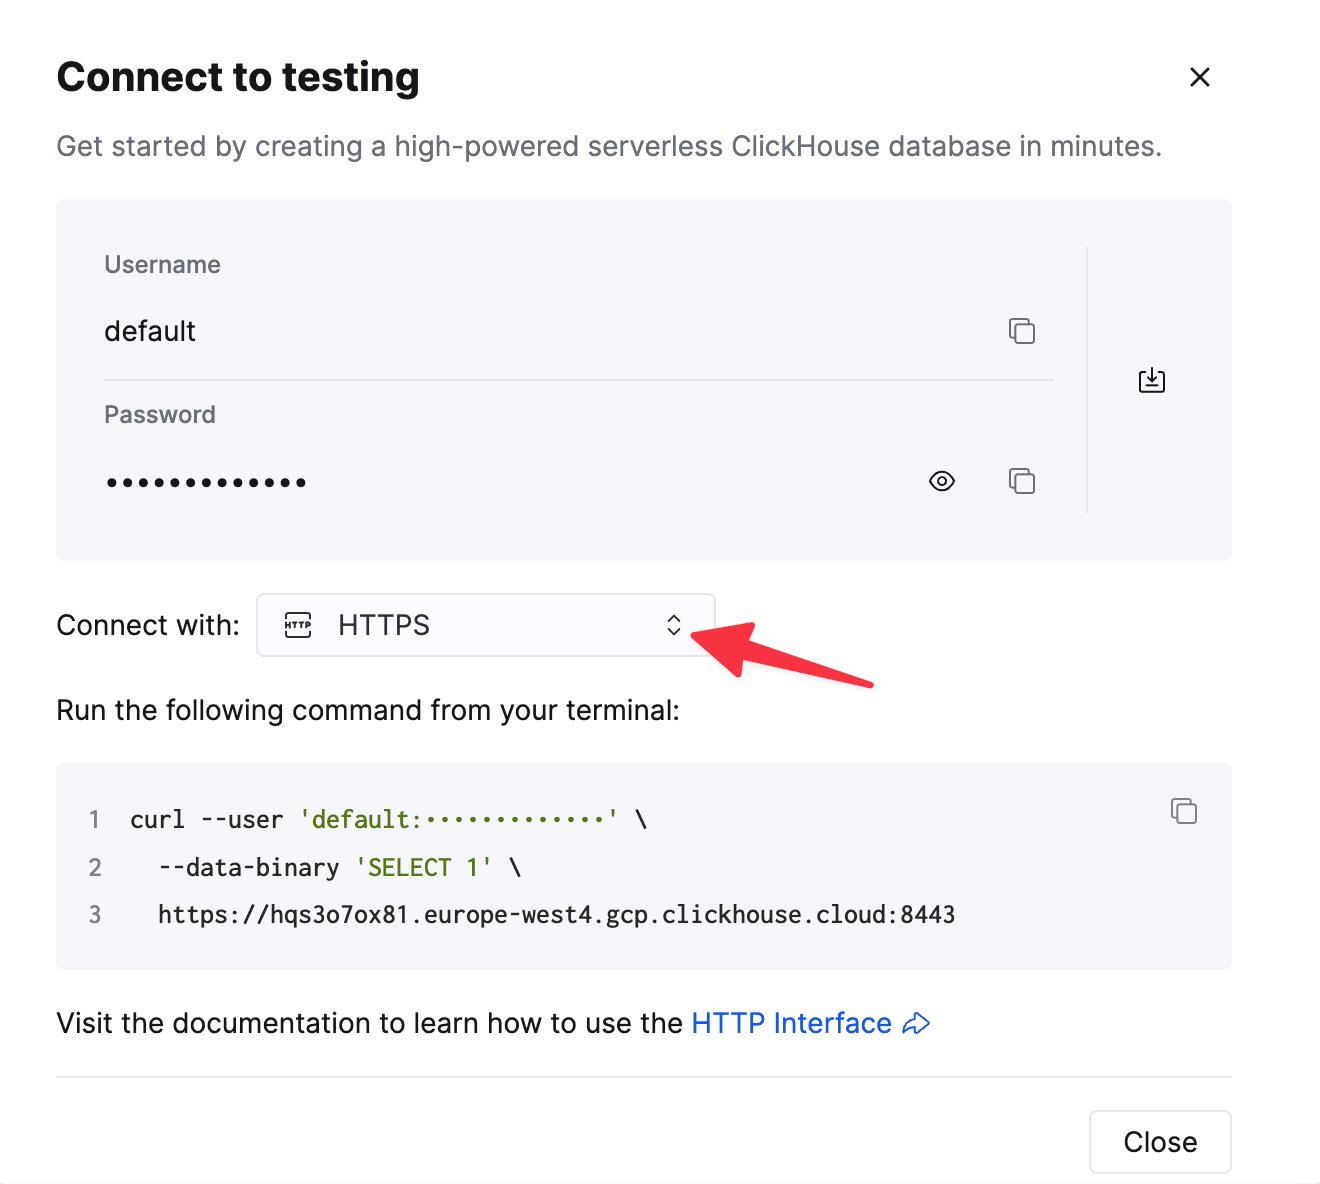
Pour vous connecter à ClickHouse via HTTP(S), vous avez besoin des informations suivantes :
Les informations de votre service ClickHouse Cloud sont disponibles dans la console ClickHouse Cloud.
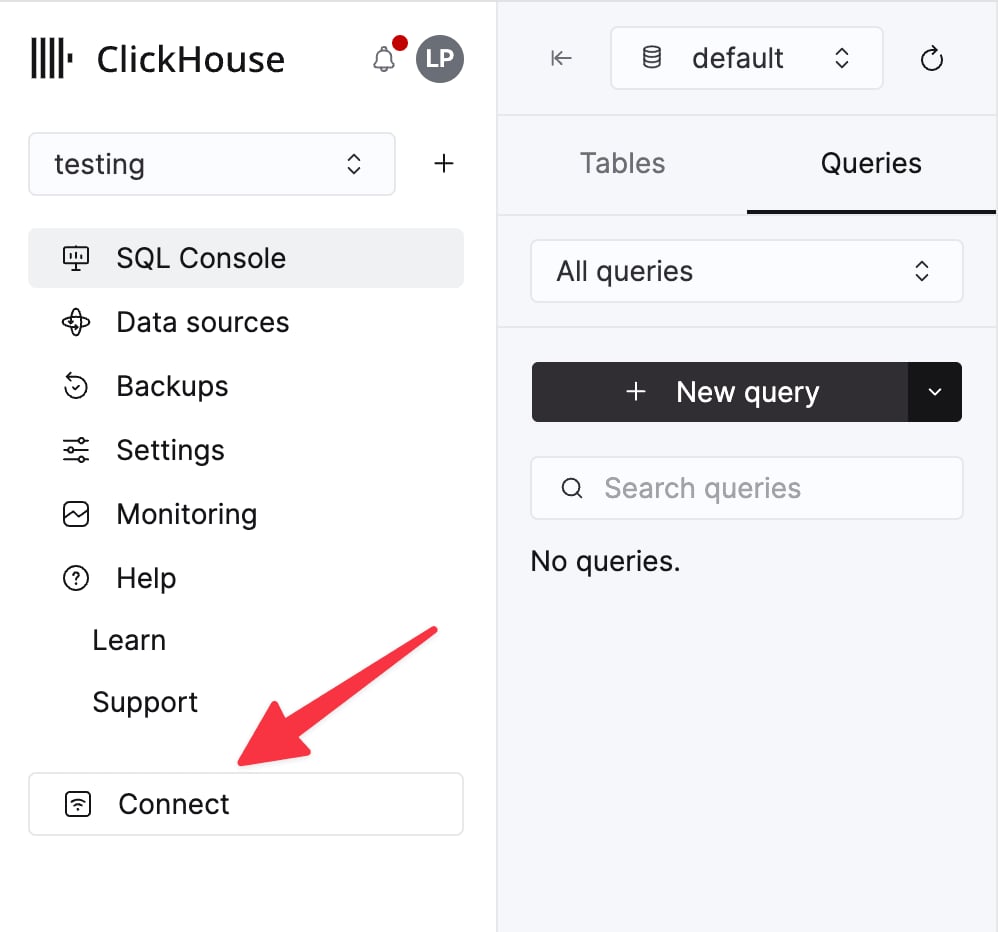
Sélectionnez un service, puis cliquez sur Connect :
curl.
Instructions générales d’installation
Le connecteur est distribué sous la forme d’un unique fichier JAR contenant tous les fichiers de classes nécessaires à l’exécution du plugin. Pour installer le plugin, suivez les étapes suivantes :- Téléchargez une archive ZIP contenant le fichier JAR du connecteur depuis la page Releases du dépôt ClickHouse Kafka Connect Sink.
- Extrayez le contenu du fichier ZIP et copiez-le à l’emplacement souhaité.
- Ajoutez à la configuration plugin.path de votre fichier de propriétés Connect le chemin du répertoire du plugin, afin que Confluent Platform puisse le trouver.
- Indiquez dans la config le nom du topic, le hostname de l’instance ClickHouse et le mot de passe.
- Redémarrez Confluent Platform.
- Si vous utilisez Confluent Platform, connectez-vous à l’UI du Confluent Control Center pour vérifier que le ClickHouse Sink figure dans la liste des connecteurs disponibles.
Options de configuration
Pour connecter le ClickHouse Sink au serveur ClickHouse, vous devez fournir :- les informations de connexion : nom d’hôte (obligatoire) et port (facultatif)
- les identifiants utilisateur : mot de passe (obligatoire) et nom d’utilisateur (facultatif)
- la classe du connecteur :
com.clickhouse.kafka.connect.ClickHouseSinkConnector(obligatoire) - topics ou topics.regex : les topics Kafka à interroger ; les noms de topic doivent correspondre aux noms de table (obligatoire)
- les convertisseurs de clé et de valeur : à définir selon le type de données de votre topic. Obligatoire s’ils ne sont pas déjà définis dans la configuration du worker.
Tables cibles
ClickHouse Connect Sink lit les messages des topics Kafka et les écrit dans les tables appropriées. ClickHouse Connect Sink écrit les données dans des tables existantes. Veuillez vous assurer qu’une table cible avec un schéma adapté a été créée dans ClickHouse avant de commencer à y insérer des données. Chaque topic nécessite une table cible dédiée dans ClickHouse. Le nom de la table cible doit correspondre au nom du topic source.Prétraitement
Si vous devez transformer les messages sortants avant leur envoi à ClickHouse Kafka Connect Sink, utilisez les transformations Kafka Connect.Types de données pris en charge
Avec un schéma déclaré :-
(1) - JSON est pris en charge uniquement lorsque les paramètres ClickHouse incluent
input_format_binary_read_json_as_string=1. Cela fonctionne uniquement avec la famille de formats RowBinary, et ce paramètre affecte toutes les colonnes de la requête d’insertion ; elles doivent donc toutes être de type chaîne. Dans ce cas, le connecteur convertit STRUCT en chaîne JSON. -
(2) - Lorsqu’une struct contient des unions comme
oneof, le convertisseur doit être configuré pour NE PAS ajouter de préfixe/suffixe aux noms de champs. Il existe le paramètregenerate.index.for.unions=falsepourProtobufConverter.
Exemples de configuration
Voici quelques exemples de configuration courants pour vous aider à démarrer rapidement.Configuration de base
La configuration minimale pour démarrer : elle suppose que vous exécutez Kafka Connect en mode distribué, qu’un serveur ClickHouse s’exécute surlocalhost:8443 avec SSL activé, et que les données sont au format JSON sans schéma.
La configuration du connecteur ci-dessus exige d’activer les client overrides dans la configuration de votre worker via
connector.client.config.override.policy=All. Pour en savoir plus, consultez la documentation de Kafka Connect.Configuration de base avec plusieurs topics
Le connecteur peut consommer des données à partir de plusieurs topicsConfiguration de base avec DLQ
Prise en charge du schéma Avro
Correspondance des types Avro
La correspondance de types ci-dessous est définie pario.confluent.connect.avro.AvroConverter, l’implémentation officielle de sérialisation/désérialisation Avro de Kafka Connect. Consultez la documentation de Kafka Connect pour plus d’informations sur la logique de conversion avancée.
✅ : Pris en charge
❌ : Non pris en charge
️⚠️ : Partiellement pris en charge
Reportez-vous à Types de données pris en charge pour la correspondance entre les types Kafka Connect et les types ClickHouse.
Schémas Avro non pris en charge
Les schémas Avro suivants ne sont pas pris en charge par le connecteur :- type logique
decimalde type fixed
- unions Nullable
- unions d’enregistrements
Prise en charge du schéma Protobuf
Correspondance des types Protobuf
La correspondance des types ci-dessous est définie pario.confluent.connect.protobuf.ProtobufConverter, l’implémentation officielle du sérialiseur/désérialiseur Protobuf dans Kafka Connect. Consultez la documentation de Kafka Connect pour plus d’informations sur la logique de conversion.
✅ : Pris en charge
❌ : Non pris en charge
️⚠️ : Partiellement pris en charge
Reportez-vous à Types de données pris en charge pour la correspondance entre les types Kafka Connect et les types ClickHouse.
Remarque sur la traduction des champs oneof en colonnes ClickHouse
Le connecteur ne prend pas en charge la traduction des unions Protobuf (oneof) vers le type Variant de ClickHouse. Indiquez plutôt les champs oneof séparément comme des champs nullable dans le schéma de votre table ClickHouse.
Par exemple :
Schémas Protobuf non pris en charge
Les schémas Protobuf suivants ne sont pas pris en charge par le connecteur sur les versions plus anciennes de ClickHouse :- unions multi-messages (avant la version 26.1 de CH, et avant la version 26.9 de CH sauf si un paramètre est activé, voir ci-dessous)
allow_experimental_nullable_tuple_type = 1 (voir cette page de la documentation).
Prise en charge du schéma JSON
Prise en charge de String
Le connecteur prend en charge le convertisseur String avec différents formats ClickHouse : JSON, CSV et TSV.Mise en mémoire tampon interne
La mise en mémoire tampon interne permet à la tâche sink d’accumuler des enregistrements issus de plusieurs appels àpoll() et de les envoyer à ClickHouse sous forme de batches plus volumineux. Cela peut améliorer le débit dans les workloads où chaque interrogation produit de nombreux petits batches par partition.
Comportement clé :
bufferCountcontrôle le nombre d’enregistrements mis en mémoire tampon avant leur envoi.bufferFlushTimedéfinit le temps d’attente maximal (en millisecondes) avant l’envoi des enregistrements mis en mémoire tampon.bufferFlushTimen’a d’effet que lorsquebufferCount > 0.bufferCount=0etbufferFlushTime=0laissent la mise en mémoire tampon désactivée (comportement par défaut).- La mise en mémoire tampon n’est pas prise en charge lorsque
exactlyOnce=true.
exactlyOnce=false dans la config de votre connecteur, soit la mise en mémoire tampon avec bufferCount=0.
Exemple :
Journalisation
La journalisation est fournie automatiquement par la plateforme Kafka Connect. La destination et le format des logs peuvent être configurés via le fichier de configuration de Kafka Connect. Si vous utilisez Confluent Platform, vous pouvez consulter les logs en exécutant une commande CLI :Supervision
ClickHouse Kafka Connect expose des métriques d’exécution via Java Management Extensions (JMX). JMX est activé par défaut dans Kafka Connector.Métriques spécifiques à ClickHouse
Le connecteur expose des métriques personnalisées via le nom MBean suivant :Métriques des producteurs et consommateurs Kafka
Le connecteur expose les métriques standard des producteurs et consommateurs Kafka, qui donnent de la visibilité sur le flux de données, le débit et les performances. Métriques au niveau du topic :records-sent-total: Nombre total d’enregistrements envoyés au topicbytes-sent-total: Nombre total d’octets envoyés au topicrecord-send-rate: Taux moyen d’enregistrements envoyés par secondebyte-rate: Nombre moyen d’octets envoyés par secondecompression-rate: Ratio de compression obtenu
records-sent-total: Nombre total d’enregistrements envoyés à la partitionbytes-sent-total: Nombre total d’octets envoyés à la partitionrecords-lag: Lag actuel de la partitionrecords-lead: Avance actuelle de la partitionreplica-fetch-lag: Informations de lag des répliques
connection-creation-total: Nombre total de connexions créées vers le nœud Kafkaconnection-close-total: Nombre total de connexions ferméesrequest-total: Nombre total de requêtes envoyées au nœudresponse-total: Nombre total de réponses reçues du nœudrequest-rate: Taux moyen de requêtes par seconderesponse-rate: Taux moyen de réponses par seconde
- Débit : Suivre les débits d’ingestion des données
- Lag : Identifier les goulots d’étranglement et les retards de traitement
- Compression : Mesurer l’efficacité de la compression des données
- État des connexions : Surveiller la connectivité réseau et la stabilité
Métriques du Kafka Connect Framework
Le connecteur s’intègre au Kafka Connect Framework et expose des métriques sur le cycle de vie des tâches et le suivi des erreurs. Métriques d’état des tâches :task-count: Nombre total de tâches dans le connecteurrunning-task-count: Nombre de tâches actuellement en cours d’exécutionpaused-task-count: Nombre de tâches actuellement en pausefailed-task-count: Nombre de tâches en échecdestroyed-task-count: Nombre de tâches détruitesunassigned-task-count: Nombre de tâches non attribuées
running, paused, failed, destroyed, unassigned
Métriques d’erreur :
deadletterqueue-produce-failures: Nombre d’écritures dans la DLQ ayant échouédeadletterqueue-produce-requests: Nombre total de tentatives d’écriture dans la DLQlast-error-timestamp: Horodatage de la dernière erreurrecords-skip-total: Nombre total d’enregistrements ignorés en raison d’erreursrecords-retry-total: Nombre total d’enregistrements ayant fait l’objet d’une nouvelle tentativeerrors-total: Nombre total d’erreurs rencontrées
offset-commit-failures: Nombre d’échecs de commit des offsetsoffset-commit-avg-time-ms: Temps moyen des commits d’offsetoffset-commit-max-time-ms: Temps maximal des commits d’offsetput-batch-avg-time-ms: Temps moyen de traitement d’un batchput-batch-max-time-ms: Temps maximal de traitement d’un batchsource-record-poll-total: Nombre total d’enregistrements récupérés
Bonnes pratiques de supervision
- Surveillez le consumer lag : suivez
records-lagpar partition afin d’identifier les goulots d’étranglement du traitement - Suivez les taux d’erreur : surveillez
errors-totaletrecords-skip-totalpour détecter les problèmes de qualité des données - Vérifiez l’état des tâches : surveillez les métriques d’état des tâches pour vous assurer qu’elles s’exécutent correctement
- Mesurez le débit : utilisez
records-send-rateetbyte-ratepour suivre les performances d’ingestion - Surveillez l’état des connexions : vérifiez les métriques de connexion au niveau des nœuds afin de détecter d’éventuels problèmes réseau
- Suivez l’efficacité de la compression : utilisez
compression-ratepour optimiser le transfert de données
Limitations
- Les suppressions ne sont pas prises en charge.
- La taille du lot est héritée des propriétés du consommateur Kafka.
- Lorsque vous utilisez KeeperMap pour exactly-once et que l’offset est modifié ou réinitialisé à une valeur antérieure, vous devez supprimer le contenu de KeeperMap pour ce topic spécifique. (Consultez le guide de dépannage ci-dessous pour plus de détails)
Réglage des performances et optimisation du débit
Cette section présente des stratégies de réglage des performances pour le ClickHouse Kafka Connect Sink. Le réglage des performances est essentiel lorsque vous traitez des cas d’usage à haut débit ou que vous devez optimiser l’utilisation des ressources et minimiser la latence.Quand l’optimisation des performances est-elle nécessaire ?
L’optimisation des performances est généralement nécessaire dans les cas suivants :- Charges de travail à haut débit : lorsque vous traitez des millions d’événements par seconde depuis des topics Kafka
- Consumer lag : lorsque votre connecteur ne parvient pas à suivre le rythme de production des données, ce qui entraîne un décalage croissant
- Contraintes de ressources : lorsque vous devez optimiser l’utilisation du CPU, de la mémoire ou du réseau
- Topics multiples : lorsque vous consommez simultanément plusieurs topics à fort volume
- Petites tailles de message : lorsque vous traitez de nombreux petits messages qui bénéficieraient d’un regroupement côté serveur par lots
- Vous traitez des volumes faibles à modérés (< 10 000 messages/seconde)
- Le consumer lag est stable et acceptable pour votre cas d’usage
- Les paramètres par défaut du connecteur répondent déjà à vos exigences de débit
- Votre cluster ClickHouse peut facilement absorber la charge entrante
Comprendre le flux des données
Avant tout réglage, il est important de comprendre comment les données circulent dans le connecteur :- Kafka Connect Framework récupère en arrière-plan les messages des topics Kafka
- Le connecteur interroge le tampon interne du framework pour récupérer les messages
- Le connecteur regroupe en lots les messages selon la taille du poll
- ClickHouse reçoit l’insertion par lot via HTTP/S
- ClickHouse traite l’insertion (de manière synchrone ou asynchrone)
Réglage de la taille des lots dans Kafka Connect
Le premier niveau d’optimisation consiste à contrôler la quantité de données que le connecteur reçoit de Kafka à chaque lot. Kafka Connect (le framework) récupère les messages des topics Kafka en arrière-plan, indépendamment du connecteur :fetch.min.bytes: quantité minimale de données avant que le framework ne transmette les valeurs au connecteur (par défaut : 1 octet)fetch.max.bytes: quantité maximale de données à récupérer dans une seule requête (par défaut : 52428800 / 50 MB)fetch.max.wait.ms: temps d’attente maximal avant le renvoi des données sifetch.min.bytesn’est pas atteint (par défaut : 500 ms)
Sur Confluent Cloud, l’ajustement de ces paramètres nécessite l’ouverture d’un ticket de support via Confluent Cloud.
max.poll.records: Nombre maximal d’enregistrements renvoyés lors d’une seule opération de poll (par défaut : 500)max.partition.fetch.bytes: Quantité maximale de données par partition (par défaut : 1048576 / 1 MB)
Sur Confluent Cloud, la modification de ces paramètres nécessite l’ouverture d’un ticket de support via Confluent Cloud.
Les propriétés ci-dessus nécessitent d’activer les client overrides dans la configuration de votre worker via
connector.client.config.override.policy=All. Consultez la documentation Kafka Connect pour plus d’informations.- Lots plus volumineux = meilleures performances d’ingestion dans ClickHouse, moins de parts, moins de surcharge
- Lots plus volumineux = utilisation mémoire plus élevée, augmentation potentielle de la latence de bout en bout
- Lots trop volumineux = risque de dépassement de délai, d’erreurs OutOfMemory ou de dépassement de
max.poll.interval.ms
Insertions asynchrones
Les insertions asynchrones sont particulièrement utiles lorsque le connecteur envoie des lots relativement petits ou lorsque vous souhaitez optimiser davantage l’ingestion en confiant à ClickHouse la gestion du traitement par lots. Envisagez d’activer les insertions asynchrones dans les cas suivants :- Nombreux petits lots : votre connecteur envoie fréquemment de petits lots (< 1000 lignes par lot)
- Concurrence élevée : plusieurs tâches du connecteur écrivent dans la même table
- Déploiement distribué : vous exécutez de nombreuses instances du connecteur sur différents hôtes
- Surcoût lié à la création de parts : vous rencontrez des erreurs « too many parts »
- Charge de travail mixte : vous combinez une ingestion en temps réel avec des charges liées aux requêtes
- Vous envoyez déjà de grands lots (> 10,000 lignes par lot) à une fréquence maîtrisée
- Vous avez besoin d’une visibilité immédiate des données (les requêtes doivent voir les données instantanément)
- La sémantique d’exactement une fois avec
wait_for_async_insert=0est incompatible avec vos exigences - Votre cas d’usage peut plutôt tirer parti d’améliorations du batching côté client
- Reçoit la requête d’insertion du connecteur
- Écrit les données dans un tampon en mémoire (au lieu de les écrire immédiatement sur le disque)
- Renvoie une confirmation de succès au connecteur (si
wait_for_async_insert=0) - Vide le tampon sur le disque lorsqu’une de ces conditions est remplie :
- Le tampon atteint
async_insert_max_data_size(par défaut : 100 MB) async_insert_busy_timeout_msmillisecondes se sont écoulées depuis le premier insert (par défaut : 1000 ms)- Le nombre maximal de requêtes accumulées est atteint (
async_insert_max_query_number, par défaut : 100)
- Le tampon atteint
clickhouseSettings :
async_insert=1: Active les insertions asynchroneswait_for_async_insert=1(recommandé) : Le connecteur attend que les données soient écrites dans le stockage ClickHouse avant d’envoyer un accusé de réception. Cela garantit la livraison.wait_for_async_insert=0: Le connecteur envoie immédiatement un accusé de réception après la mise en mémoire tampon. Les performances sont meilleures, mais les données peuvent être perdues en cas de plantage du serveur avant leur écriture sur le stockage.
async_insert_max_data_size(par défaut : 104857600 / 100 MB) : Taille maximale du tampon avant vidageasync_insert_busy_timeout_ms(par défaut : 1000) : Temps maximal (ms) avant vidageasync_insert_stale_timeout_ms(par défaut : 0) : Temps (ms) écoulé depuis la dernière insertion avant vidageasync_insert_max_query_number(par défaut : 100) : Nombre maximal de requêtes avant vidage
- Avantages : Moins de parts, meilleures performances de fusion, surcharge CPU réduite, débit amélioré en cas de forte concurrence
- Considérations : Les données ne peuvent pas être interrogées immédiatement, latence de bout en bout légèrement plus élevée
- Risques : Perte de données en cas de plantage du serveur si
wait_for_async_insert=0, risque de pression sur la mémoire avec de grands tampons
exactlyOnce=true avec l’insertion asynchrone :
wait_for_async_insert=1 avec exactly-once afin de garantir que les commits d’offsets n’ont lieu qu’une fois les données persistées.
Pour plus d’informations sur l’insertion asynchrone, consultez la documentation ClickHouse sur l’insertion asynchrone.
Parallélisme du connecteur
Augmentez le parallélisme pour améliorer le débit :- Nombre maximal de tâches réellement efficaces = nombre de partitions du topic
- Chaque tâche maintient sa propre connexion à ClickHouse
- Plus de tâches = plus de surcoût et un risque accru de contention sur les ressources
tasks.max égal au nombre de partitions du topic, puis ajustez en fonction des métriques de CPU et de débit.
Par défaut, le connecteur regroupe les messages en lots par partition. Pour un débit plus élevé, vous pouvez regrouper les lots sur plusieurs partitions :
exactlyOnce=false. Ce paramètre peut améliorer le débit en créant des lots plus volumineux, mais supprime les garanties d’ordre par partition.
Plusieurs topics à haut débit
Si votre connecteur est configuré pour s’abonner à plusieurs topics, que vous utiliseztopic2TableMap pour associer les topics aux tables et que vous rencontrez un goulot d’étranglement lors des insertions, entraînant un consumer lag, envisagez plutôt de créer un connecteur par topic.
La principale raison est qu’actuellement, les lots sont insérés dans chaque table en série.
Recommandation : pour plusieurs topics à fort volume, déployez une instance de connecteur par topic afin de maximiser le débit des insertions en parallèle.
Considérations relatives au moteur de table ClickHouse
Choisissez le moteur de table ClickHouse adapté à votre cas d’utilisation :MergeTree: idéal pour la plupart des cas d’utilisation, offre un bon équilibre entre les performances de requête et d’insertionReplicatedMergeTree: requis pour la haute disponibilité, ajoute une surcharge liée à la réplication*MergeTreeavec unORDER BYapproprié : optimisez en fonction de vos modèles de requêtes
Pool de connexions et dépassements de délai
Le connecteur maintient des connexions HTTP avec ClickHouse. Ajustez les dépassements de délai pour les réseaux à forte latence :socket_timeout(par défaut : 30000 ms) : Temps maximal pour les opérations de lectureconnection_timeout(par défaut : 10000 ms) : Temps maximal pour établir une connexion
Tampon réseau du client
Lors de l’utilisation du client V2 ("client_version": "V2"), les données sont copiées entre le socket et la mémoire de l’application via un tampon contrôlé par client_network_buffer_size (en octets). Sa taille par défaut est de 300000 octets. Un tampon plus grand peut améliorer le débit sur des liaisons à forte latence ou à large bande passante, mais augmente l’utilisation de la mémoire par tâche de connexion.
Toutes les options du client se configurent via jdbcConnectionProperties plutôt que via clickhouseSettings. Par exemple :
& :
Surveillance et dépannage des performances
Surveillez ces métriques clés :- Consumer lag : utilisez les outils de monitoring Kafka pour suivre le lag par partition
- Métriques du connecteur : surveillez
receivedRecords,recordProcessingTime,taskProcessingTimevia JMX (voir Monitoring) - Métriques ClickHouse :
system.asynchronous_inserts: surveillez l’utilisation du buffer des insertions asynchronessystem.parts: surveillez le nombre de parts pour détecter les problèmes de fusionsystem.merges: surveillez les fusions activessystem.events: suivezInsertedRows,InsertedBytes,FailedInsertQuery
Résumé des bonnes pratiques
- Commencez par les valeurs par défaut, puis mesurez et ajustez en fonction des performances réelles
- Privilégiez des lots plus volumineux : visez 10,000-100,000 lignes par insertion lorsque c’est possible
- Utilisez l’insertion asynchrone lorsque vous envoyez de nombreux petits lots ou en cas de forte concurrence
- Utilisez toujours
wait_for_async_insert=1avec une sémantique exactly-once - Effectuez une mise à l’échelle horizontale : augmentez
tasks.maxjusqu’au nombre de partitions - Un connecteur par topic à fort volume pour un débit maximal
- Surveillez en continu : suivez le consumer lag, le nombre de parts et l’activité de merge
- Testez de manière approfondie : testez toujours les changements de configuration sous une charge réaliste avant un déploiement en production
Exemple : configuration à haut débit
Voici un exemple complet optimisé pour un débit élevé :La configuration du connecteur ci-dessus exige que vous activiez les client overrides dans la configuration de votre worker via
connector.client.config.override.policy=All. Consultez la documentation de Kafka Connect pour plus d’informations.- Traite jusqu’à 10 000 enregistrements par poll
- Regroupe les données de plusieurs partitions en lots pour des inserts plus volumineux
- Utilise l’insertion asynchrone avec un buffer de 16 Mo
- Exécute 8 tasks en parallèle (à aligner sur votre nombre de partitions)
- Optimisée pour le débit plutôt que pour un ordre strict
Dépannage
“Incohérence d’état pour le topic [someTopic] partition [0]”
Cela se produit lorsque l’offset stocké dans KeeperMap est différent de celui stocké dans Kafka, généralement lorsqu’un topic a été supprimé
ou que l’offset a été modifié manuellement.
Pour corriger cela, vous devez supprimer les anciennes valeurs stockées pour ce topic + cette partition :
Cet ajustement peut avoir des conséquences sur la sémantique exactly-once.
“Quelles erreurs le connecteur retentera-t-il ?”
À l’heure actuelle, l’accent est mis sur l’identification des erreurs transitoires pouvant faire l’objet d’une nouvelle tentative, notamment :ClickHouseException- Il s’agit d’une exception générique pouvant être levée par ClickHouse. Elle est généralement levée lorsque le serveur est surchargé, et les codes d’erreur suivants sont considérés comme particulièrement transitoires :- 3 - UNEXPECTED_END_OF_FILE
- 107 - FILE_DOESNT_EXIST
- 159 - TIMEOUT_EXCEEDED
- 164 - READONLY
- 202 - TOO_MANY_SIMULTANEOUS_QUERIES
- 203 - NO_FREE_CONNECTION
- 209 - SOCKET_TIMEOUT
- 210 - NETWORK_ERROR
- 241 - MEMORY_LIMIT_EXCEEDED
- 242 - TABLE_IS_READ_ONLY
- 252 - TOO_MANY_PARTS
- 285 - TOO_FEW_LIVE_REPLICAS
- 319 - UNKNOWN_STATUS_OF_INSERT
- 425 - SYSTEM_ERROR
- 999 - KEEPER_EXCEPTION
SocketTimeoutException- Cette exception est levée lorsque le délai d’attente du socket est dépassé.UnknownHostException- Cette exception est levée lorsque l’hôte ne peut pas être résolu.IOException- Cette exception est levée en cas de problème réseau.
“Toutes mes données sont vides/à zéro”
Il est probable que les champs de vos données ne correspondent pas à ceux de la table - c’est particulièrement fréquent avec le CDC (et le format Debezium). Une solution courante consiste à ajouter la transformationflatten à la configuration de votre connecteur :
_ comme délimiteur). Les champs de la table suivront alors le format “field1_field2_field3” (par ex. “before_id”, “after_id”, etc.).
“Je veux utiliser mes clés Kafka dans ClickHouse”
Par défaut, les clés Kafka ne sont pas stockées dans le champvalue, mais vous pouvez utiliser la transformation KeyToValue pour déplacer la clé dans le champ value (sous le nouveau nom de champ _key) :